En bref : le 30 septembre 2026, Google a ouvert à Barcelone le premier Search Central Live Deep Dive en Europe. D’après plusieurs participants qui ont publié sur LinkedIn le jour même, le message du jour 1 est celui de Bangkok 2025 : AI Overviews et AI Mode reposent sur le même système de crawl et d’indexation que la recherche classique. Aucune annonce produit. Mises à jour : jour 2 ajouté le 1er octobre (meta robots, rendering JavaScript, canonicalisation, données structurées, hreflang, Google Trends), jour 3 ajouté le 3 octobre (query understanding, qualité, spam, Discover, délais de crawl, d’indexation et de serving). Je n’y suis pas : cet article agrège et recoupe ces retours (recaps ROAST, posts LinkedIn).
LinkedIn, 3 octobre 2026 : Victoria Yap ; Estela Franco ; Stefanie Senn ; Marieke Botman ; Fernando Maciá ; Friederike Hagen ; Robert Wojno ; Rafa Labrador ; Kira Breuer ; George-Emanuel Cîță ; Dave Smart ; Elham Borojerdi.
Qu’est-ce qui s’est passé au Google Search Central Live Deep Dive à Barcelone ?
Le Search Central Live Deep Dive Europe 2026 se tient du 30 septembre au 2 octobre à Barcelone. C’est la première édition européenne du format Deep Dive, lancé à Bangkok en juillet 2025 (le recap de la Search Central Live Paris 2026 couvre l’édition française). L’événement est gratuit, sur candidature, entièrement en anglais. Selon l’annonce officielle du blog Google Search Central, le programme suit le parcours d’une page dans Google Search :
- Jour 1 (30 septembre) : fondations et crawling, avec Search Console pour diagnostiquer les problèmes de découverte.
- Jour 2 (1er octobre) : indexation, rendering, duplication et canonicalisation, internationalisation, rôle de l’IA dans l’indexation.
- ROAST : Google Search Central Live Deep Dive, Barcelona, Day 1 Recap (John Campbell, 30 septembre 2026)
- ROAST : Google Search Central Live Deep Dive, Barcelona, Day 2 Recap (John Campbell, 1er octobre 2026)
- Google Search Central : fonctionnalités IA et votre site
- Jour 3 (2 octobre) : serving, ranking, fonctionnalités de recherche basées sur l’IA, Google Trends.
Côté Google, PPC Land cite Cherry Prommawin, Gary Illyes et Martin Splitt. Deux participants mentionnent aussi la présence de John Mueller (posts LinkedIn de La Teva Web et de Clara Soteras Acosta). Clara Soteras Acosta cite également Lino Cattaruzzi. Dans le post de présentation des intervenants communautaires, Gary Illyes et Cherry Prommawin précisent qu’une grande partie du contenu reprend celui de Bangkok, avec des sujets nouveaux « mostly AI focused ».
Quels chiffres sur AI Mode ont été annoncés au Deep Dive de Barcelone ?
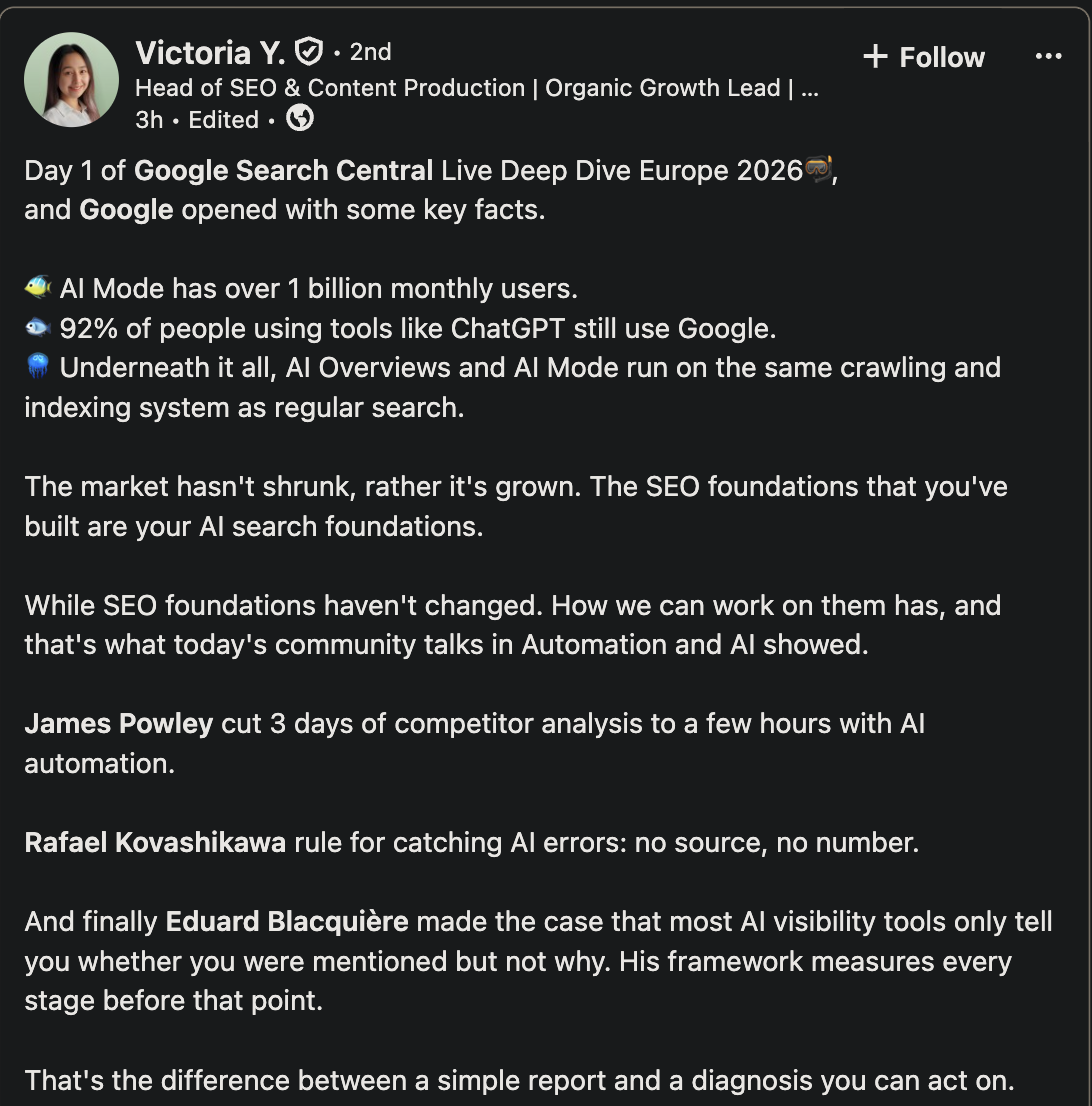
Deux participants rapportent des données présentées sur scène. Ces chiffres viennent de posts LinkedIn, pas d’un document Google : à prendre comme des chiffres rapportés, pas vérifiés. Mise à jour : le recap ROAST attribue à Gary Illyes le doublement trimestriel, des requêtes environ 3 fois plus longues et 1 requête sur 6 multimodale, ce qui recoupe George-Emanuel Cîță. Les 1 milliard et les 92 % n’ont toujours qu’une source.
| Donnée rapportée | Source |
|---|---|
| AI Mode dépasse 1 milliard d’utilisateurs mensuels | Victoria Y., Head of SEO & Content Production |
| 92 % des utilisateurs d’outils type ChatGPT utilisent encore Google | Victoria Y. |
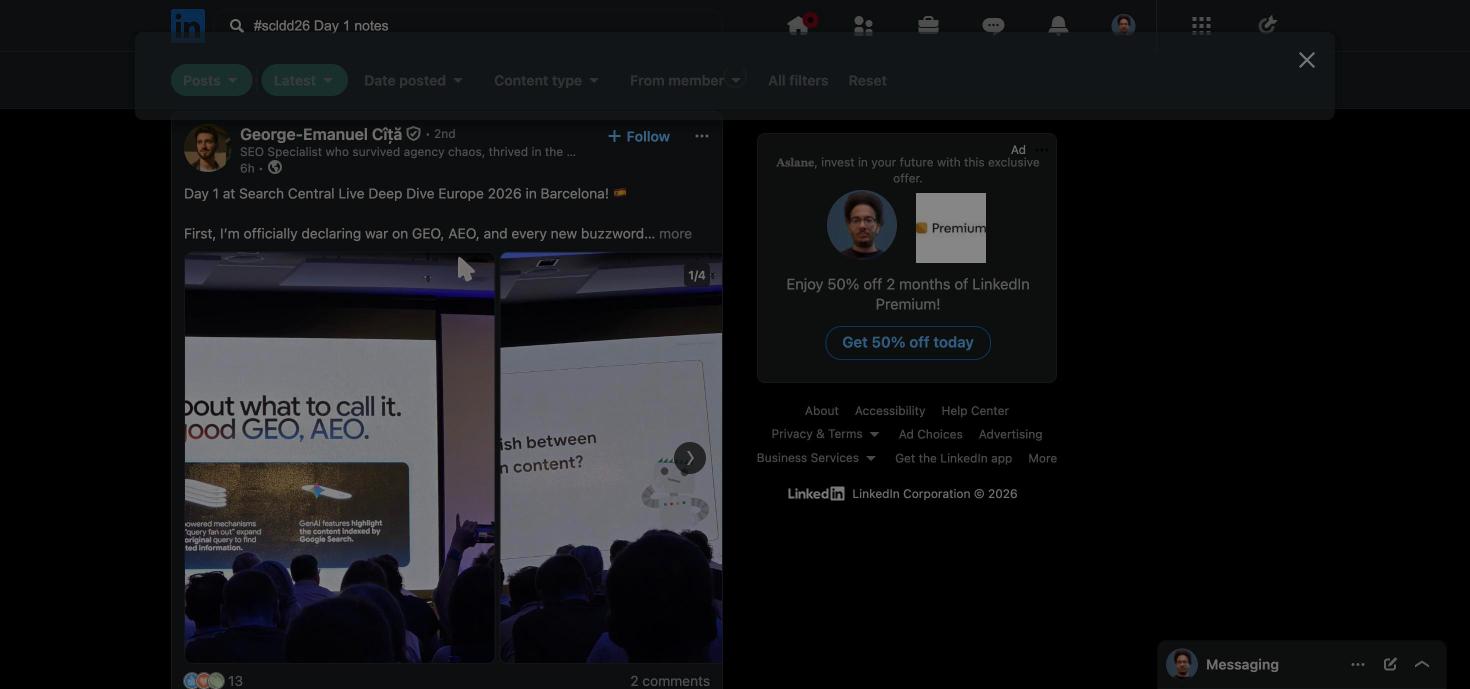
| Les recherches AI Mode doublent chaque trimestre, requêtes environ 3 fois plus longues, 1 sur 6 multimodale | George-Emanuel Cîță, SEO Specialist |
AI Overviews et AI Mode utilisent-ils le même système que la recherche classique ?
Oui, selon trois retours indépendants du jour 1. Victoria Y. écrit qu’AI Overviews et AI Mode « run on the same crawling and indexing system as regular search ». John Campbell (Head of Innovation & AI, ROAST) note que ce qui alimente AIO et AI Mode est « la même stack SEO ». George-Emanuel Cîță résume : « good SEO is good GEO, AEO, AIO ».
Rien de neuf, et ça recoupe la checklist GEO de Google. À Bangkok en 2025, Gary Illyes avait déjà indiqué que le SEO classique suffit pour les AI Overviews et que Google ne supporte pas llms.txt, d’après un post de Kenichi Suzuki relayé par Search Engine Land. Barcelone confirme la ligne, sans nuance pour l’instant. Le jour 2 apporte des précisions sur l’indexation, plus bas.
Que dit Google du crawl budget au Deep Dive de Barcelone ?
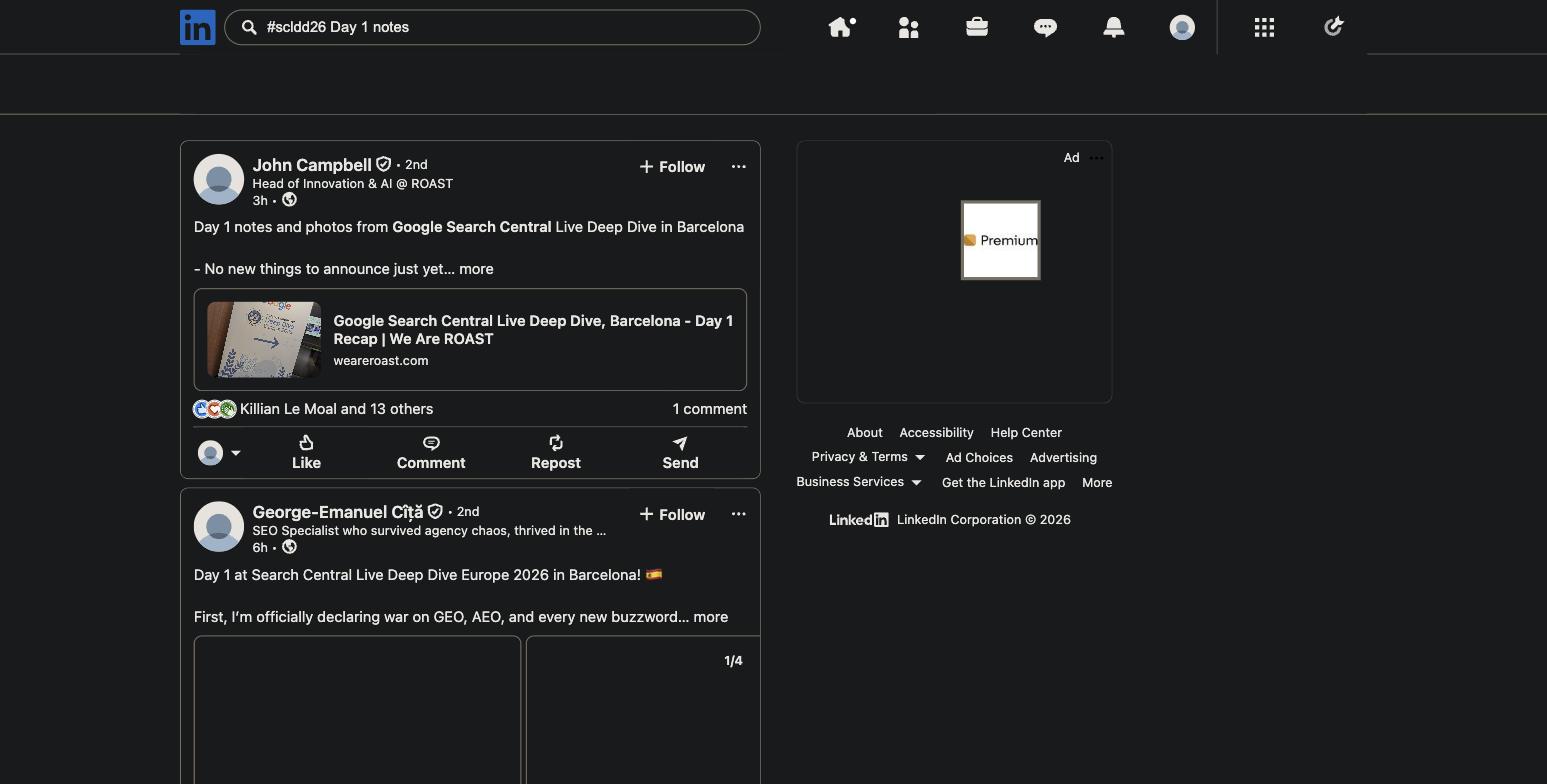
John Campbell rapporte une phrase : « You can buy crawl budget, get a better and faster server ». George-Emanuel Cîță confirme que des sessions ont couvert le crawling, l’impact des erreurs de crawl et l’interprétation du robots.txt et des crawl budgets. Je n’ai pas le contexte de cette phrase : elle va dans le sens de la documentation Google sur la capacité de crawl (un serveur rapide permet à Googlebot de crawler davantage), mais elle ne dit rien d’un éventuel critère de demande. Je ne l’extrapole pas.
Google a-t-il fait des annonces au Search Central Live Deep Dive ?
Non. John Campbell : « No new things to announce just yet », avec des « teasers on new data points that could come in the future ». Cohérent avec le format : un parcours pédagogique, pas un événement produit. Les annonces éventuelles sont à guetter sur les jours 2 et 3 et sur le blog Search Central.
Que dit Google sur la qualité du contenu ?
Clara Soteras Acosta (post LinkedIn, 30 septembre 2026) rapporte que Gary Illyes, John Mueller, Lino Cattaruzzi et Cherry Prommawin sont revenus à plusieurs reprises sur l’expérience et la qualité du contenu, avec la notion de « non-commodity content » (contenu non banalisé).
Mon avis côté GEO, pas une déclaration de Google : les données originales, les retours terrain et les cas clients, un LLM ne peut pas les reconstituer à partir du web ouvert, donc ce sont eux qu’il a le plus de raisons de citer. À tester sur vos requêtes.
Que disent les speakers de la communauté sur l’IA et l’automatisation ?
Selon Victoria Y., les talks communautaires du jour 1 portaient sur l’automatisation et l’IA :
- James Powley : analyse concurrentielle ramenée de 3 jours à quelques heures par automatisation IA.
- LinkedIn, 1er octobre 2026 : Nicolas Audemar ; Jamie R. ; Patrik Rojan ; David Iwanow ; Michael Field ; Bruno Díaz González ; Thiago Pojda ; Enrique Hidalgo ; Liv Day ; Cecilia Valentina Dulcich ; Fernando Maciá Domene ; Neil McCarthy
- Google Search Central : versions localisées de vos pages (hreflang)
- Rafael Kovashikawa : règle anti-erreurs IA, « no source, no number ».
- Eduard Blacquière : la plupart des outils de visibilité IA disent si une marque est mentionnée mais pas pourquoi ; son cadre mesure chaque étape en amont de la mention.
- Kira Breuer : talk de 7 minutes (lightning talk) sur ses automatisations IA, selon son propre post.
- John McAlpin (LOCOMOTIVE) : analyse de données pour détecter les problèmes de SEO technique qui bloquent la visibilité IA ; write-up annoncé par son agence.
Le point d’Eduard Blacquière rejoint un constat de terrain : un tracker qui compte les mentions ne diagnostique pas (voir le comparatif Profound, Otterly et Ahrefs Brand Radar). Pour un audit GEO, il faut remonter la chaîne : crawlable, rendu, indexé, compris, sélectionné. Christina Mantziou le formule ainsi : être disponible n’est pas être compris, et être compris n’est pas être sélectionné.
Jour 1 du Search Central Live Deep Dive : keynote, crawl et lightning talks
Le recap du jour 1 de John Campbell (ROAST) détaille une journée consacrée uniquement au crawl. Voilà ce qui n’était pas encore dans cet article.
Keynote de Lino Cattaruzzi (président de Google Iberia). La mission ne change pas, mais les attentes des utilisateurs, si : des plateformes fermées captent des recherches (donc du trafic perdu pour le web ouvert), le contenu doit être personnalisé, authentique, visuel et facile à scanner, et l’IA répond à de nouveaux besoins. Cinq évolutions annoncées : des tests permanents avec intégration au cœur de Search une fois validés, une SERP qui va au-delà des liens et des pubs (vidéos, cartes), plusieurs besoins servis en même temps, la priorité à la qualité (le contenu « Made for Search » sous-performera) et des fluctuations de trafic présentées comme des opportunités.
AI Mode, version Gary Illyes. Depuis le lancement : volume de requêtes qui double chaque trimestre, requêtes environ 3 fois plus longues, 1 sur 6 multimodale, et plus de 40 % de follow-ups en plus par mois aux États-Unis. Quatre usages : Explore (le brainstorming croît 30 % plus vite que l’ensemble), Learn, Decide (les requêtes « which » croissent 40 % plus vite en six mois) et Do (la planification croît 80 % plus vite). Sa conclusion : une seule URL ne répond pas à une question longue en plusieurs parties, l’IA assemble donc des réponses à partir de plusieurs sources.
Crawlers. Search, AI Overviews et AI Mode dépendent du même crawler principal, Googlebot. Gemini utilise pour l’instant un crawler séparé.
Erreurs de crawl. Les erreurs DNS sont pénibles à déboguer, et les CDN bloquent de plus en plus les bots : une config Cloudflare peut couper Googlebot sans que personne ne le voie. Les pages CAPTCHA renvoyées en 200 sans vrai contenu sont traitées comme des soft 404.
Robots.txt (Dave Smart). Les ressources hébergées sur un autre domaine (CDN, sous-domaine) suivent le robots.txt de ce domaine. Une page peut sembler bien configurée alors que ses ressources sont bloquées ailleurs.
Crawl budget (Cherry Prommawin). Un seul système de crawl central sert Search, Ads, Shopping et Images. La limite de débit (hostload) est partagée entre tous les crawlers Google d’un host et dépend du temps de connexion, du TTFB et des codes 429 et 5xx : si ça monte, le crawl ralentit. La demande de crawl dépend de la qualité du site, de la fréquence de changement des URLs et de leur popularité ; quand Google ne les connaît pas, il remonte vers les chemins parents. Ce qui gaspille du budget : erreurs, pages inutiles et espaces d’URLs infinis (calendriers, paramètres).
Le « What would you do ? » du crawl (John Mueller et Gary Illyes). Trois scénarios. Un cache CDN périmé sur 500 000 fiches produit : Gary conseille d’attendre, John de servir un 503 sur le robots.txt pour mettre le crawl en pause. Un WAF qui sert des 429 et 503 pendant un flash sale (crawl en baisse de 90 %) : Gary vérifie le serveur et corrige le WAF, John ne fait rien. Un sous-domaine de staging crawlé (50 000 URLs) : Gary vire le développeur, John passe par l’outil de suppression de la Search Console. Pour les autres cas, la réponse était un honnête « ça dépend du contexte ».
Lightning talks. Carlos Ortega Roldán sur les agents IA : inutiles, llms.txt, les versions Markdown (duplication) et le robots.txt (un agent qui agit pour un utilisateur peut le contourner) ; utiles, un CLS bas (les agents lisent des screenshots), le schema en vérification secondaire, des titres bien imbriqués, des landmarks HTML sémantiques, l’ARIA et WebMCP. Lino Uruñuela : audit de JSON-LD par IA avec une boucle de correction (code, erreurs Google et doc Google en entrée, validateur Google, 3 essais maximum). Kira Breuer : rapports mensuels en Python via l’API Search Console, qui plafonne à 50 000 lignes, avec l’export en masse vers BigQuery comme alternative. Thiago Pojda : le SEO se score, le GEO se mesure mal ; vendre le JSON-LD comme porte d’entrée des réponses IA est un faux pas ; les listicles marchent ; le query fan-out existe, parfois dans une autre langue que le prompt. Tobias Schwartz : repérer les URLs quasi identiques (encodage, http/https, www, ordre des paramètres). Jovana Avramovic : l’IA change les workflows, pas les principes.
Jour 2 du Search Central Live Deep Dive : indexation, JavaScript et canonicals
Mise à jour du 1er octobre 2026. La base est le recap du jour 2 publié par John Campbell (ROAST), qui assiste à l’événement, recoupé avec des posts LinkedIn de participants. Le jour 3 a sa propre section plus bas.
Meta robots (John Mueller). Il a présenté les directives peu connues comme max-snippet et max-video-preview. Pour un maximum de visibilité, il recommande max-image-preview:large et max-snippet:-1, d’après ROAST. Enrique Hidalgo ajoute le revers : nosnippet et max-snippet:0 empêchent l’usage du contenu dans AI Overviews et AI Mode, mais suppriment aussi le snippet dans les résultats classiques. Voir la doc Google sur les fonctionnalités IA.
Rendering JavaScript. Erin Sparling a détaillé le pipeline : Google charge la page avec un viewport d’environ 10 000 pixels de haut, sans scroller ni cliquer, donc un contenu déclenché au scroll ne se rend pas. Rebecca Yu a rappelé qu’un robots.txt qui bloque les fichiers JavaScript empêche Google de construire la page, même si elle s’affiche bien dans un navigateur. Liv Day confirme : c’est plus courant qu’on le croit. Sören Bendig a montré des sites réels qui bloquent des ressources nécessaires à l’exécution du JS.
Contenu de la page et soft 404 (Gary Illyes). Google privilégie le contenu principal face à la navigation, au footer et au boilerplate. Selon Enrique Hidalgo, il extrait header, navigation et main content, le footer pesant beaucoup moins, et il a parlé de tokenisation. Les soft 404 (page en 200 qui ressemble à une page vide ou en erreur) sont revenus plusieurs fois, avec comme causes citées le contenu thin, les erreurs serveur ou CMS et les problèmes de JavaScript.
Doublons et canonicals (John Mueller). Google regroupe les pages similaires, choisit un canonical et consolide les signaux. Ses recos, d’après ROAST : redirections pour les migrations, bons codes HTTP, vérifier les rel=canonical, hreflang pour la localisation, signaler les canonicals bizarres sur les forums, des signaux de canonical sans ambiguïté. Enrique Hidalgo retient que 301, 302, canonicalisation, clustering et crawling sont des notions distinctes : un 301 est un signal fort de canonicalisation, sans pour autant « mieux crawler » qu’un 302. Et hreflang ne garantit pas que deux URLs quasi identiques (pays, devise ou navigation qui changent, le reste identique) ne finissent pas regroupées. Tobias Schwarz (écrit aussi Schwartz selon les sources) a montré des boucles de canonicals et des clusters sans chef clair.
Données structurées et médias (Gary Illyes). Images, vidéos et données structurées sont extraites et envoyées à un moteur d’indexation média distinct. Le Schema.org alimente AI Overviews et AI Mode comme contexte, pas comme du code. Ryan Levering : « It’s never negative to have structured data », la vraie question étant de savoir si l’effort se justifie. Nicolas Audemar rapporte la logique : les modèles se trompent encore, certaines infos restent ambiguës et faire tourner de gros modèles sur chaque page coûte bien plus cher qu’une donnée explicitement structurée. Liv Day nuance : plus de balisage n’est pas automatiquement plus utile.
Images et vidéo. Sitemaps d’images (utiles surtout pour les images chargées en JavaScript), élément picture avec fallback img, WebP ou AVIF avec un poids équilibré. Pour la vidéo : au-dessus de la ligne de flottaison sur mobile, texte descriptif autour, sitemap vidéo. Enrique Hidalgo ajoute une page dédiée par vidéo, une miniature représentative et des titres orientés intention. Irene Cecotti a raconté un cas où l’alt text généré par IA à grande échelle via Screaming Frog a fait baisser le trafic : aller vite n’est pas aller mieux, et la sortie IA en volume se contrôle.
Structure de l’index (Gary Illyes). Les requêtes sont découpées en mots, chacun pointant vers une liste de pages, et Google croise ces listes. Les embeddings vectoriels fonctionnent en parallèle de ce système, selon ROAST.
International. Cherry Prommawin a listé les erreurs hreflang courantes : cumuler plusieurs méthodes d’implémentation, se tromper de codes langue, oublier la localisation au-delà de la traduction (formats de date, devise). Patrik Rojan relaie ses conseils : localiser d’abord pour les utilisateurs (marché, langue, pays, devise), puis aider les bots avec hreflang. Un ccTLD par localisation est l’idéal, sous-domaines et sous-dossiers marchent aussi. Google déduit la langue du contenu, pas des hreflang, ce qui colle avec la doc Google sur les versions localisées. Côté communauté, Alizée Baudez a pris l’exemple d’un revendeur de meubles néerlandais en retard sur sa version française malgré une bonne traduction : les maisons néerlandaises, étroites et verticales, ne collaient pas aux visuels pensés pour les intérieurs français. Elham Borojerdi a parlé des caractères qui se ressemblent en persan et en arabe, qui compliquent la recherche de mots-clés.
Google Trends (Omri Weisman). Gemini dans Explore (suggestion de termes, comparaison de jusqu’à 8 tendances), comparaisons rapides entre périodes, cartes mondiales avec sous-régions, filtre par catégorie de retour. Trending Now se met à jour en 10 minutes, utile pour repérer des trous de contenu réactif. Pas d’API publique annoncée.
Poster session. John Campbell a présenté un outil gratuit sur Google Sheets qui automatise le contrôle quotidien du statut d’indexation de centaines ou milliers d’URLs via l’API d’inspection de Search Console, dans la limite de 2 000 inspections par jour et par site. Il suit les évolutions comme les sorties d’index ou les changements de canonical.
Le fil rouge, selon Michael Field : comment la recherche classique fonctionne aujourd’hui et nourrit AI Overviews et AI Mode, avec beaucoup de réponses en « it depends ». Bruno Díaz González (La Teva Web) retient surtout le risque des sites en tout ou partie JavaScript que Google (et l’IA) peinent à traiter. Thiago Pojda (SIXT) a présenté « GEO is not ‘Just SEO’ (or maybe it is?) » au jour 1, en 7 minutes, avec des données d’Ahrefs, Dan Petrovic, Peec AI et iPullRank.
Détails en plus du recap. Pour un article de blog, le titre et le corps comptent, pas la liste de catégories de la sidebar. Les mots sont tokenisés avec une indication de leur place dans le contenu principal.
Google dédoublonne pour éviter les doublons dans les résultats, garder de la place dans l’index pour du contenu unique, consolider les signaux et comprendre les variantes (hreflang, changement de marque, migration). C’est aussi pour ça qu’un site: sur l’ancien domaine affiche encore des résultats après une migration.
Migration. Martyna Ağanoğlu a fusionné deux marques en un seul domaine avec un nouveau site lancé en même temps : 2 000 pages ramenées à 100, sans perte de trafic et avec plus de revenu. David Carrasco Pamies rappelle que la difficulté d’une migration vient des personnes, pas de la technique.
Schema.org (Ryan Levering, ingénieur Google). Les données sont nettoyées et filtrées avant d’apparaître dans les résultats ou d’alimenter AI Overviews et AI Mode. Des mises à jour shopping sont annoncées (détail dans la section du jour 3), avec une validation côté serveur bientôt.
Autres lightning talks. Patrick Domanico (dentsu) utilise l’IA pour éditer des transcriptions d’interviews et rendre interviews, podcasts et vidéos cherchables. Natalia Venditto (Adobe) a présenté le « reframing », pour intégrer des apps générées par IA dans un site, présenté comme un standard émergent. Zahra Laleh et Elham Borojerdi, talk commun sur le SEO multilingue : Zahra n’a pas pu être présente à Barcelone, c’est Elham qui a présenté leur travail sur scène. Leur point : en persan et en arabe, des orthographes presque identiques sont des recherches différentes, et les vieilles tactiques SEO tiennent plus longtemps car les mises à jour de Google arrivent plus tard.
Index et Trends. Gary Illyes a montré les posting lists : une requête comme « embed a robots.txt file into an audio file » est découpée en mots, chacun pointe vers une liste d’URLs, et Google croise ces listes. Omri Weisman a ouvert sur un quiz, puis conseillé de chercher les anomalies : un pic peut venir de recherches liées, et une baisse globale ne veut pas dire moins de demande. Astuce bonus : trends.google.com/tv affiche les Trends en direct sur un écran.
Ce qui s’est ajouté sur le jour 1 du Deep Dive de Barcelone
Postés le 1er octobre, ces retours précisent ou nuancent le jour 1. Ce sont des posts LinkedIn, pas des documents Google.
Search Console et llms.txt. Cecilia Valentina Dulcich retient que Search Console ajoute un contrôle pour exclure son site d’AI Overviews et d’AI Mode, sans impact sur le ranking web selon Google, et que llms.txt n’est pas nécessaire, pas plus que le découpage du contenu en fragments pour l’IA : la reco est d’optimiser pour les personnes. Ce contrôle Search Console ne vient que de son post, à confirmer. Jamie R. rapporte aussi « oubliez le chunking de contenu », sa paraphrase et non une citation.
Chiffres attribués à Lino Cattaruzzi (Jamie R.). Plus de 5 000 milliards de recherches par an, requêtes AI Mode 2 à 3 fois plus longues, 94 % des utilisateurs fréquents de LLM qui utilisent aussi Google. Victoria Y. parlait de 92 % la veille : les deux sont à confirmer. Jamie R. note aussi que Google prévoit d’étendre les agents dans AI Mode (réservation d’hôtels déjà possible aux États-Unis) et détaille le cadre d’Eduard Blacquière en cinq étapes (Know, Associate, Search, Retrieve, Selection), alors que la plupart ne mesurent que la dernière.
Le contexte, selon Neil McCarthy. Les keynotes de Lino Cattaruzzi et Gary Illyes ont posé que Google a changé parce que les résultats traditionnels ne répondent plus aux requêtes nouvelles et plus complexes. Google reconnaît que les SEO peinent avec la perte de KPI et les fluctuations de trafic, tout en insistant que Google reste la place où être. Gary Illyes aurait dit qu’on peut appeler ça GEO si on veut, mais que les fondamentaux du SEO technique restent essentiels.
Une voix critique. Fernando Maciá Domene juge le niveau très vulgarisé et loin de ses attentes, et doute que les SEO de la salle confirment que Google envoie plus de trafic que jamais, comme l’a affirmé le discours officiel avec 5 000 milliards de recherches l’an dernier.
Jour 3 du Search Central Live Deep Dive : serving, ranking, qualité et spam
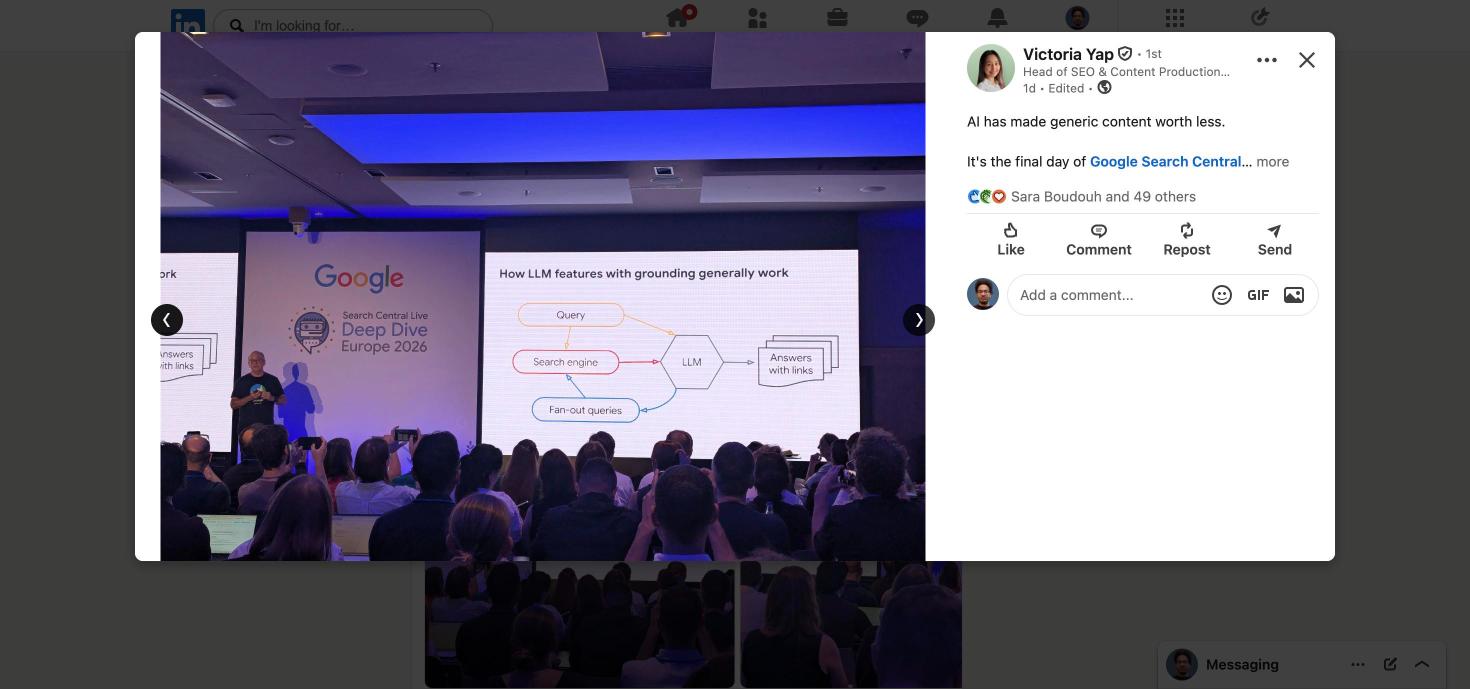
Mise à jour du 3 octobre 2026. La base est le recap du jour 3 de John Campbell (ROAST), qui est sur place, recoupé avec des posts LinkedIn (dont celui de Victoria Yap avec des photos de slides). Ce sont des résumés de seconde main, pas des citations de Google. Le fil rouge du jour : la recherche est passée en revue après l’index, c’est à dire comprendre la requête, récupérer des candidats, puis ranker.
Comprendre la requête (John Mueller). Détection de la langue (plus dure pour les noms de marque, la localisation aide), retrait des stop words, reconnaissance d’entités (les stop words restent dans « The Lord of the Rings »). L’expansion par synonymes est décrite comme une partie très importante du ranking : « fried chicken place » s’étend vers « restaurant », « location », « area ». Le sens dépend du contexte (GM : General Motors ou génétiquement modifié). Canon et Nikon ne sont pas des synonymes mais des « siblings », repérés grâce aux recherches « X vs Y ». Côté IA, les LLM génèrent des requêtes fan-out envoyées à la recherche. Elles n’apparaissent pas dans Search Console, mais peuvent se voir dans Gemini ou via des API.
Retrieval (Gary Illyes). Langue et pays sont des signaux critiques à l’étape de récupération. La qualité décide ensuite quels candidats passent au ranking. Le retrieval vient avant le ranking : Google réduit d’abord les candidats de l’index, puis les classe. Sur les photos de Victoria Yap, une slide montre un tableau d’URLs avec langue, pays et qualité (high, med, low). Mon hypothèse est qu’elle illustre ce point, mais la photo est trop floue pour l’affirmer.
Grounding et fan-out. Une autre slide résume comment les fonctionnalités LLM avec grounding fonctionnent : requête, moteur de recherche, LLM, réponses avec liens, avec une boucle de requêtes fan-out entre le moteur et le LLM. Même message que les jours 1 et 2 : l’IA s’appuie sur la recherche.
Qualité (Duy Nguyen, Google). Quatre piliers : effort, originalité, talent ou compétence, exactitude. Des centaines de signaux de ranking, qui varient selon le type de résultat, et des tests en continu. Il recommande de lire les Search Quality Rater Guidelines, qui sont publiques. Le contenu de faible qualité inonde le web, qu’il soit écrit par un humain ou par une IA. Exemples cités en positif : tests de chaussures avec des métriques originales, photos propres, recherche détaillée.
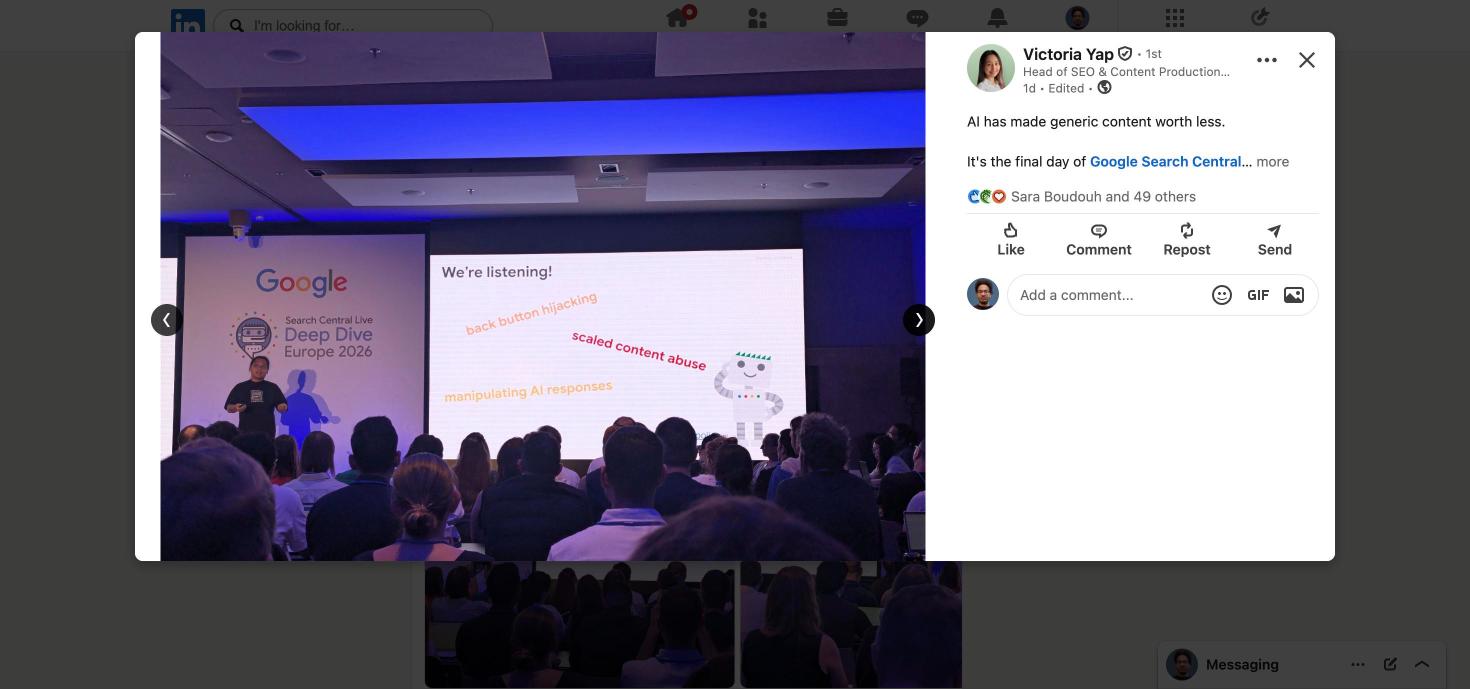
Spam et core updates (Gary Illyes). Google filtrerait 40 milliards de pages de spam par jour (ROAST, source unique). Il y a plus de spam updates parce que l’IA fait exploser le volume de contenu, et Google utilise aussi l’IA pour en attraper davantage. Trois moteurs de changement : des formats de contenu plus nombreux (au delà des dix liens bleus), un contenu plus large, et des problèmes de contenu. Les core updates ciblent des pages, pas des domaines, ce qui explique que certaines pages montent et d’autres descendent sur un même site. Les spam updates couvrent cloaking, doorway pages, contenu scrapé, link spam, contenu piraté et, de plus en plus, le contenu produit à grande échelle. Une slide « We’re listening! » cite trois abus : back button hijacking, scaled content abuse et manipulation des réponses IA.
Discover (Eric Murillo, Google). Pas de bot Discover : c’est la même pile d’index que le reste. Une « Eligibility Gate » : violation de politique, contenu filtré ; faible qualité (E-E-A-T), contenu filtré ; contenu sûr et fiable, éligible à Discover. Ensuite la qualité d’image joue sur le CTR : petite miniature, CTR plus bas ; grande image haute résolution, CTR plus haut. Recommandations rapportées : au moins 1 200 px de large, plus de 300 000 pixels au total, ratio 16:9, et max-image-preview:large activé. Éviter les images génériques (logos) et celles avec beaucoup de texte, qui suivent les mêmes règles que le contenu (pas d’image trompeuse ou exagérée). Eric note que le « AI slop » augmente dans le feed. Les retours des utilisateurs alimentent de nouveaux filtres anti-spam, et les actions manuelles apparaissent dans Search Console.
Rich results et shopping. Gary : les rich results demandent en général des données structurées, alors que les résultats IA extraient depuis le texte. Google Images peut utiliser les images produit du Merchant Center, qui n’est pas obligatoire pour apparaître mais ajoute une voie d’indexation. Alex Jansen (Google) présente les « conversational attributes » : une information produit flexible qui remplace des milliers d’attributs fixes, pour répondre à des questions comme « quelle quantité d’eau ? » ou « quelles sécurités ? » sur une bouilloire. Plus un champ « product highlights ». Message : le niveau de qualité attendu sur la donnée produit monte (ROAST, source unique).
Search Console (Ariel Kroszynski). Sur l’année : Groups (création avec regex), configuration des rapports assistée par IA, et le multimodal en dernier. Pas de nouveauté sur le rapport IA générative : l’équipe travaille à y ajouter plus de données de recherche IA, sans calendrier. Un mock-up de dark mode a été montré, pas encore réel.
Lightning talks qualité et SERP. Robert Wojno (Hostinger) : « What is VPS hosting? » (1,6 M d’impressions) fait moins bien qu’un guide de niche sur Palworld (46 K impressions), avec un CTR 23 fois plus haut et de meilleures conversions. Juan Seguí (acceseo) : l’IA a besoin d’une vérification humaine ; dire qu’une poussette double est « compacte » ne dit pas si elle rentre dans un ascenseur avec un parent et un enfant ; des FAQ détaillées ont apporté +14 % de clics organiques et moins de questions avant achat. Noe Rivas (seosve) : choisir le bon format pour l’audience, par exemple un sujet simplifié pour débutants avec une vidéo, qui ressort dans AI Overviews, Gemini, YouTube et Images. Nik Vujic : Search Console et GA4 dans des agents LLM, avec une métrique comme « l’article ranke-t-il sur plus de requêtes avec le temps ? ». Simon Vreeman : monter une hiérarchie de preuves (avis d’experts, cas) avant de tester. Alex Wright (iDHL) : un cas où les sessions organiques baissent de 47 % (direct à -2 %) alors que les demandes par 100 clics sont multipliées par 2,7, la part de clics de la marque passe de 17 % à 38 %, le CTR Ads grimpe de 36 %, la marque est 1re ou 2e dans cinq moteurs IA et 83 % des citations IA viennent de sites tiers (ROAST, cas unique). Pablo Pérez (Google) revient sur la « Messy Middle » : au Royaume-Uni, la recherche « is [brand] legit » monte depuis 2020 avec un pic en 2026, la confiance fait partie du parcours.
Les délais moyens de Gary Illyes. La slide qui a le plus circulé. Ce sont des valeurs moyennes rapportées, pas une doc Google. Estela Franco (LinkedIn) en confirme l’essentiel pour le crawl, l’indexation et le serving. Selon ROAST, la capacité de crawl chute tout de suite si le serveur peine, les core updates se déploient sur 2 à 4 semaines et les spam updates en 1 à 2 jours. Un « jamais » est souvent lié à la qualité : un correctif technique rapide n’aide pas si Google dévalue la page.
| Processus | Typique | Cas lent |
|---|---|---|
| Crawl : découverte d’une nouvelle URL | ~20 h | Semaines, voire jamais |
| Crawl : refresh d’une URL connue | ~30 jours | Semaines, voire jamais |
| Traitement d’un sitemap | ~24 h | Jusqu’à 14 jours, voire jamais (qualité) |
| Prise en compte du robots.txt | ~24 h | 25 h |
| Indexation de bout en bout | ~1,5 h | Mois, voire jamais (qualité) |
| Annotations meta | 45 à 90 min | 1 à 4 jours |
| Changement de canonical | 1 à 3 semaines | Mois (signaux contradictoires) |
| Suppression d’une URL de l’index | 1 à 3 semaines | Mois |
| Site move | 1 à 3 mois | 6 mois à plus d’un an |
| Suppression via Search Console | ~2 h | 24 h |
| Mise à jour d’un snippet ou d’un title | 1 à 2 jours | Semaines à mois |
| Récupération après core update | 3 à 6 mois | 6 mois à 1 an (update suivante) |
| Récupération après spam update | 1 à 2 semaines | Mois (rafraîchissements par lots) |
La clôture (Gary Illyes). Trois messages : utiliser l’IA parce qu’elle fluidifie le travail, l’utiliser avec responsabilité parce qu’elle hallucine (et ne pas amplifier le « AI slop » avec ses briefs), et rappeler que l’IA sur Google, c’est du SEO. Les mêmes processus alimentent les résultats IA et classiques, pas besoin de nouveaux acronymes. Sa phrase de fin : les résultats IA sont construits sur l’infrastructure SEO, le SEO n’est pas mort.
Ce que disent les participants. Stefanie Senn reprend « Good SEO is good GEO, AEO » et propose UEO pour User Engine Optimization. Marieke Botman note que « GEO is just good SEO » est revenu plusieurs fois, que tout le monde n’était peut-être pas d’accord, et que sa conclusion est « it depends ». Fernando Maciá avait trouvé le jour 1 un peu léger, mais les jours 2 et 3 plus substantiels. Côté posters, Friederike Hagen cite Sabine Langmann (migrations complexes et gestion des parties prenantes), Sergio Q. (modélisation du flux de liens internes) et Victoria Y. (ce que l’IA ne remplace pas en SEO).
Ce que j’en retiens (mon interprétation, pas une consigne de Google).
- Vérifier l’indexation avant de parler de visibilité IA : une page qui n’est pas dans l’index ne peut ni ranker ni être citée.
- Mettre les délais dans les plannings clients : canonical 1 à 3 semaines, site move 1 à 3 mois, récupération d’un core update 3 à 6 mois.
- Discover : images d’au moins 1 200 px de large, 16:9,
max-image-preview:large, pas de logo ni d’image chargée de texte. - Qualité : données originales, photos propres, détails réels et FAQ sur les vraies questions, plutôt que du contenu reformulé.
- Mesurer au delà des clics : demandes, conversions, part de clics de marque, citations IA.
- Shopping : surveiller les conversational attributes et product highlights dans Merchant Center, à confirmer côté documentation Google.
Ce que le recap Digitaloft ajoute
Liv Day (Digitaloft) a publié un recap complet des 3 jours le 4 octobre. Il recoupe plusieurs points déjà notés et en ajoute d’autres. Les chiffres ci-dessous viennent de ce recap, à citer avec cette source.
- Recoupés. Les 40 milliards de pages spam par jour (ROAST, María José G. et Digitaloft, probablement la même session). Environ 719 000 tests qualité et 4 781 lancements en 2023, cohérent avec les « ~800 000 » et « ~5 000 » des notes de Serhii Omelchenko. 94 % des utilisateurs fréquents de LLM utilisent aussi Google fréquemment, ce qui tranche en faveur du 94 % (le 92 % reste isolé). Les conversational attributes d’Alex Jansen sont aussi confirmés.
- Croissance des requêtes AI Mode (Gary Illyes). Les requêtes de plus de 5 mots progressent 1,5 fois plus vite. Par type : exploring +30 %, deciding (« which… ») +40 %, doing (planification) +80 %.
- Données structurées (Ryan Levering, Google). Deux écoles en interne : certains n’y voient pas de valeur, d’autres un socle. Apports cités : précision (formats machine comme les dates ISO), efficacité (moins cher que de faire parser par un LLM), focus. Pas de pénalité pour un balisage abondant, JSON-LD recommandé, éviter les données conflictuelles. Cas Rakuten Recipes : trafic de recherche x2,7 et durée de session x1,5. Attention, c’est un exemple ancien tiré de la documentation Google, repris sur scène.
- Attributs shopping conversationnels (Alex Jansen). question_and_answer, document_link, related_product, item_group_title, variant_option, popularity_rank. Exemple : une bouilloire avec Q&A sur les réglages de température. Le niveau d’exigence sur la qualité des données monte pour les parcours pilotés par des agents.
- Confiance. Pablo Pérez (Google, « messy middle ») : la demande de recherche « is [brand] legit? » augmente depuis 2020 et a atteint son plus haut niveau en 2026. Les utilisateurs se servent de l’IA dès le début du parcours d’achat pour explorer, comparer et se renseigner. Discover (Eric Murillo) : pas de crawl séparé, filtrage des contenus de faible qualité, aperçu qui doit correspondre à l’article, transparence sur l’auteur et l’éditeur.
- Updates. Pas d’annonce de nouvelle update. Selon Digitaloft, la spam update de septembre 2026 était encore en déploiement. Conseil Google après une core update : regarder le site dans son ensemble, pas seulement les pages touchées, et demander un regard extérieur objectif.
- À venir côté IA. Google est resté discret. Seule piste citée : des agents de recherche qui envoient des notifications et mises à jour (déploiement qui commence). Côté Search Console, pas de détail sur les futurs insights IA, seulement « on s’attend à plus ». Selon Gary Illyes, aucun système ne détermine si un contenu est écrit par une IA, mais les modèles de ML sont entraînés sur du contenu humain.
- Search Console (Ariel Kroszynski). suivi de la performance sociale, Query Groups dans Insights depuis octobre 2025 (variantes et fautes de marque), reporting multimodal (Lens, Circle to Search, upload d’images, clic droit « Rechercher cette image » dans Chrome), rapport IA générative appelé à gagner en profondeur, mode sombre en maquette sans date.
- Mesure (Alex Wright). Un cas de -65 % de clics de recherche avec +17 % de demandes, et un projet de visibilité IA associé à +36 % de CTR sur le paid search via la notoriété de marque. Cas unique, à lire comme tel.
- Requêtes (John Mueller). Pipeline : détection de langue, retrait des stopwords, extraction d’entités, expansion. Notion de « siblings » : termes non synonymes recherchés ensemble, issus des requêtes « X vs Y ». Mueller/Müller traités de façon interchangeable.
- Clôture. Trois messages : utiliser l’IA, l’utiliser de façon responsable, et « AI on Google is just SEO ».
Digitaloft rapporte aussi des cas d’indexation du jour 2 : une chaîne de canonicals sur trois URLs, 80 % de titres réécrits avec un CTR en baisse de 25 %, et des produits en rupture à garder en 200 avec le markup OutOfStock. Même réserve : ce sont des scénarios de « What would you do ? » présentés sur scène, pas des règles Google.
E-E-A-T et qualité : les notes de la communauté sur le jour 3
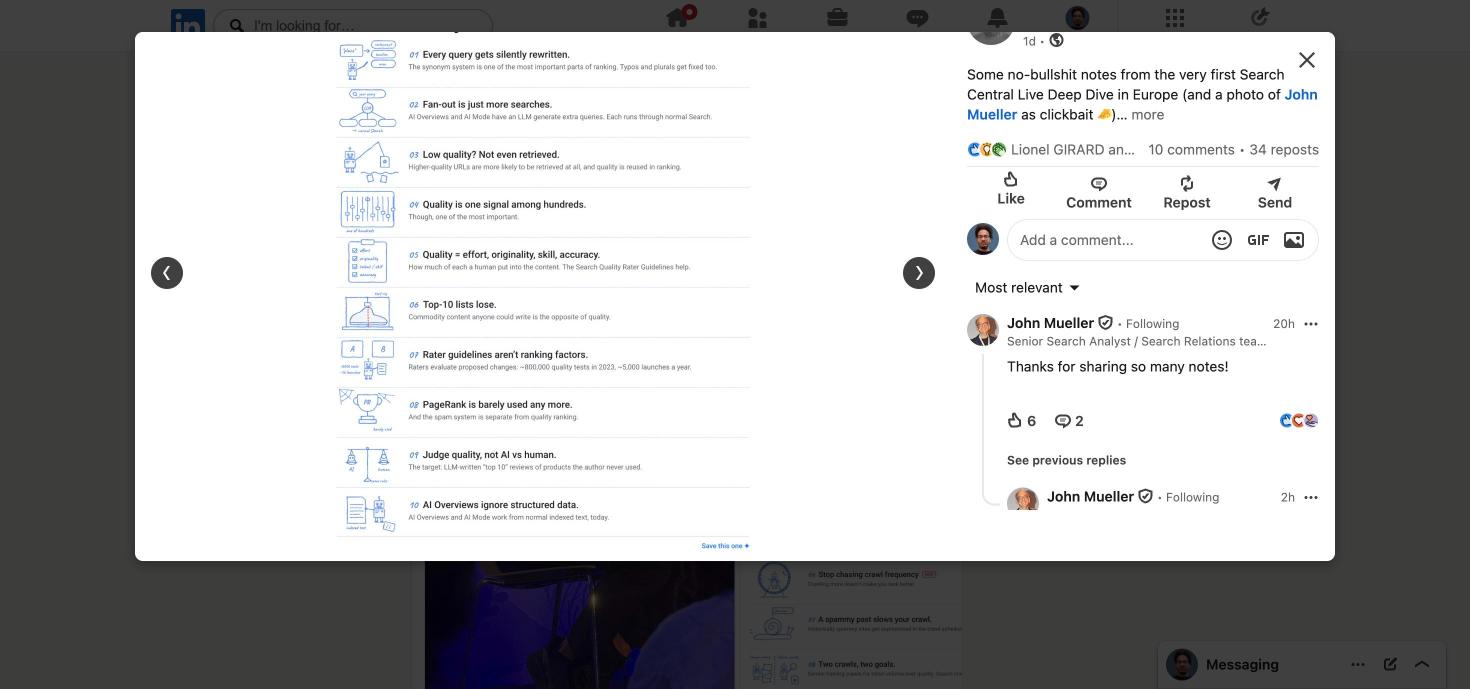
Serhii Omelchenko a publié des notes du jour 3 sous le titre « Commodity content loses » (LinkedIn, 3 octobre). Ce sont des notes de participant, pas des slides Google, à lire comme un résumé.
- La qualité se résume à l’effort, l’originalité, le talent ou la compétence, et l’exactitude. C’est un signal parmi des centaines, mais l’un des plus importants.
- Une URL de faible qualité n’est pas forcément retrouvée (retrieval), et la qualité est réutilisée ensuite dans le ranking.
- Les listes « top 10 » que n’importe qui pourrait écrire sont l’opposé de la qualité. La cible : des « top 10 » de produits rédigés par un LLM sans test réel.
- Les Search Quality Rater Guidelines ne sont pas des facteurs de ranking. Les raters évaluent des changements proposés : environ 800 000 tests qualité en 2023, environ 5 000 lancements par an.
- Google juge la qualité, pas IA contre humain. Lucian Harhata le confirme : un contenu écrit par un humain peut être du scaled content abuse.
- À vérifier (une seule source) : « PageRank is barely used any more » et « AI Overviews ignore structured data ». Sur le schema, Lucian Harhata rapporte au contraire que Google en met en avant la précision et le faible coût de traitement. Cohérent avec la doc Google : le balisage donne du contexte, il ne pilote pas les AI features.
Désiré Nahon retient que Google a placé la confiance (trust) au centre d’E-E-A-T, avec quatre fondamentaux : base technique accessible, données fraîches et exactes, effort, confiance. María José G. ajoute que l’E-E-A-T ne se construit pas du jour au lendemain, qu’il faut le traiter comme un investissement de marque, et qu’il n’existe pas encore de métrique claire pour mesurer la visibilité IA.
Autres retours LinkedIn du jour 3
- Lucian Harhata : « crawled, currently not indexed » n’est pas forcément un bug technique (qualité, duplication, contenu principal). Google Trends mesure un intérêt relatif, pas un volume. Cas communautaire cité : 2 000 URLs réduites à 100, +100 % de revenu mensuel, avec plusieurs changements simultanés.
- Shopping : fiches avec Q&A produit, spécifications détaillées et compatibilité pour répondre aux questions de type « est-ce que ça marche pour moi ».
- Stefanie Senn : Google compterait plus de 5 000 milliards de recherches par an, avec des requêtes plus complexes, conversationnelles et multimodales. Citation retenue : « Good SEO is good GEO, AEO ».
- María José G. confirme la mention de plus de 40 milliards de pages spam détectées par jour, ce qui fait deux posts mais probablement la même session.
- Thiago Pojda a présenté un lightning talk « GEO is not just SEO (or maybe it is?) » avec des données Ahrefs, Dan Petrovic, Peec AI et iPullRank.
- Maryam Safari : le Q&A de clôture réunissait Alex Jansen, John Mueller, Ariel Kroszynski, Duy Nguyen et Gary Illyes.
Sources LinkedIn : Serhii Omelchenko, Désiré Nahon, Lucian Harhata, María José G., Stefanie Senn, Thiago Pojda, Maryam Safari (3 et 4 octobre 2026).
Dernier passage de vérification (5 octobre) : ce qui change
Dernier scan Google et LinkedIn avant de clôturer cet article. Les mêmes posts reviennent d’une requête à l’autre, donc la couverture est à saturation. Voici ce qui s’ajoute ou se précise.
- Timelines : toujours une seule origine. Monica Brignoli, Robert Trif et Ajil Satheesan relaient les durées de Gary Illyes, tirées du recap de John Campbell (ROAST). Robert Trif précise que Google n’a pas publié les slides et que les chiffres viennent d’un recap de participant. Ajil Satheesan ajoute le rafraîchissement d’une URL connue (~30 jours), Monica Brignoli le traitement des sitemaps (~24 h), Robert Trif la levée d’une action manuelle (1 à 2 semaines) et des cas lents de 6 à 12 mois après un core update. Statut : 1 source, non officiel.
- Citation attribuée à Gary Illyes. « If you know how search works, you largely also know how AI features work », rapportée par Gonzalo Cobo Tirado (Bodeboca). Elle va dans le sens des retours de Lucian Harhata et de la doc Google sur les AI features. Statut : 1 source pour la formule exacte, recoupé pour l’idée.
- Intervenants Google confirmés. Javier Soria Domínguez cite Gary Illyes, John Mueller et Cherry Sireetorn Prommawin comme animateurs des trois jours.
- « Scaled content plus gros problème que le link spam ». Attribué à Gary Illyes par Ana N. (MetricLinks), qui reprend une synthèse de Lily Ray. Je ne l’ai trouvé nulle part ailleurs. Statut : 1 source indirecte. Les autres éléments de cette synthèse (mise à jour de la guidance IA de Google, 4 spam updates en 2026) ne viennent pas de Barcelone et je ne les ai pas vérifiés moi-même.
Que faire concrètement après le Search Central Live Deep Dive ?
Ces actions découlent du message convergent du jour 1 (même stack crawl et indexation). C’est mon interprétation, pas une consigne de Google.
- Vérifier le crawl avant de parler GEO. Rapport Statistiques d’exploration de Search Console : temps de réponse serveur, erreurs 5xx, pages découvertes non explorées.
- Contrôler le robots.txt pour Googlebot et les crawlers IA séparément. Un blocage involontaire supprime la page de la chaîne entière.
- Valider le rendu des contenus clés (inspection d’URL, HTML rendu) : ce qui n’est pas rendu n’est pas indexé, donc non citable.
- Exploiter le rapport IA générative de Search Console pour mesurer les impressions IA, en complément des trackers de citations. Méthode et limites dans mon analyse du rapport IA générative.
- Ne pas investir dans llms.txt pour Google (cadrage complet dans la checklist GEO). Position confirmée à Bangkok 2025 et, selon Cecilia Valentina Dulcich, répétée à Barcelone.
- Garder le balisage structuré : une donnée explicitement structurée reste plus fiable et moins coûteuse à exploiter qu’une compréhension par LLM (post de Nicolas Audemar, à confirmer avec un recap plus détaillé).
- Hreflang : ne pas compter dessus pour la détection de langue. Localiser le contenu d’abord, hreflang ensuite pour relier les versions.
- Meta robots : max-image-preview:large et max-snippet:-1 pour un maximum de visibilité (reco de John Mueller d’après ROAST). Attention, nosnippet et max-snippet:0 coupent aussi le snippet classique.
- Vérifier que le robots.txt ne bloque aucun fichier JavaScript nécessaire au rendu, et que le contenu clé ne dépend pas du scroll.
- Canonicals : garder des signaux sans contradiction entre redirections, rel=canonical et hreflang, et auditer les clusters de pages quasi identiques (variantes pays ou devise).
Qui parle du Google Search Central Live Espagne, édition Deep Dive ?
Sources primaires de cet article, publiées sur #scldd2026 et #searchcentrallive et #scldd26. Liste non exhaustive, mise à jour le 1er octobre 2026.
- Victoria Y. : Head of SEO & Content Production : chiffres AI Mode, même système de crawl et d’indexation, talks communautaires du jour 1.
- John Campbell : Head of Innovation & AI, ROAST : notes du jour 1, crawl budget, absence d’annonces.
- George-Emanuel Cîță : SEO Specialist : données AI Mode, photos de slides, « good SEO is good GEO, AEO, AIO ».
- Clara Soteras Acosta : récap du Jour 1, noms des intervenants et thème qualité du contenu.
- Nicolas Audemar (SEO international) : données structurées à l’ère de l’IA.
- Jamie R. : récap jours 1 et 2, chiffres attribués à Lino Cattaruzzi, cadre d’Eduard Blacquière.
- Patrik Rojan (Search Evolution Summit) : conseils hreflang de Cherry Prommawin.
- David Iwanow : talk d’Alizée Baudez sur les hreflang.
- Michael Field (Sykes Cottages) : fil rouge du jour 2.
- Bruno Díaz González (La Teva Web) : JavaScript.
- Thiago Pojda : talk « GEO is not ‘Just SEO’ ».
- Enrique Hidalgo (Technical SEO) : récap détaillé du jour 2, meta robots, canonicalisation, soft 404, vidéo.
- Liv Day (Digitaloft) : récap du jour 2, JavaScript et robots.txt, structured data.
- Cecilia Valentina Dulcich : récap du jour 1, Search Console, llms.txt.
- Fernando Maciá Domene (Human Level) : avis critique sur le jour 1.
- Neil McCarthy : contexte des keynotes du jour 1.
- Christina Mantziou : retour sur la chaîne disponible, comprise, sélectionnée.
- Kira Breuer : lightning talk de 7 minutes sur ses automatisations IA.
- John McAlpin et LOCOMOTIVE Europe : talk sur l’analyse de données pour détecter les blocages techniques de la visibilité IA, poster session, write-up annoncé.
- La Teva Web : participation et présence de John Mueller.
- Irene Cecotti (SEO/AEO Lead, PhantomBuster) : post avant l’événement : talk annoncé sur les nouveautés IA qui peuvent dégrader la performance organique.
- Dave Smart (Technical SEO, Tame the Bots) : post avant l’événement, sans contenu factuel.
Ce qu’on ne sait pas encore sur le Deep Dive de Barcelone
- Je ne suis pas à Barcelone. Tout ce que je rapporte du jour 1 vient de posts LinkedIn de participants, publiés le 30 septembre 2026, que j’ai lus et capturés le jour même.
- Les chiffres sur AI Mode (1 milliard d’utilisateurs, 92 %) ne figurent dans aucun document Google consulté et n’ont qu’une source. Le doublement trimestriel, les requêtes 3 fois plus longues et le 1 sur 6 multimodal sont recoupés par le recap ROAST.
- Un post néerlandais affirme que Google a dit que le contenu « naturel » est mieux promu. Trop vague et de seconde main, je ne le retiens pas.
- Le jour 2 repose surtout sur un seul recap détaillé (ROAST), recoupé par quelques posts. Certains détails (viewport de 10 000 px, contrôle Search Console pour exclure AI Overviews) sont à confirmer avec la doc Google. Le jour 3 (ranking, fonctionnalités IA) n’est pas couvert. Je mets l’article à jour dès que les recaps sortent.
- Clara Soteras Acosta parle de « moments marquants pour les éditeurs » sans donner de détail, donc je n’en dis rien.
- John Campbell a lui-même raté des sessions du jour 2 (calcul des signaux, décisions d’inclusion dans l’index, lightning session J, le « What would you do ? » de l’indexation) : je n’en dis rien.
Sources
- Google Search Central Blog : programme Deep Dive Europe 2026
- Google Search Central Blog : community speakers
- PPC Land : Barcelone, format et intervenants
- Search Engine Land : Bangkok 2025, SEO classique et llms.txt
- LinkedIn, 30 septembre 2026 : Victoria Y.; Clara Soteras Acosta; John Campbell (ROAST) ; George-Emanuel Cîță ; Christina Mantziou ; Kira Breuer ; LOCOMOTIVE Europe (John McAlpin) ; La Teva Web.
- ROAST : Google Search Central Live Deep Dive, Barcelone, recap du jour 1 (John Campbell, 30 septembre 2026)
- ROAST : Google Search Central Live Deep Dive, Barcelone, recap du jour 2 (John Campbell, 1er octobre 2026)
- ROAST : Google Search Central Live Deep Dive, Barcelone, recap du jour 3 (John Campbell, 2 octobre 2026)
- Google : AI features et votre site
- Google : versions localisées et hreflang
- Digitaloft : recap du Search Central Live Deep Dive Europe 2026 (Liv Day, 4 octobre 2026)
Laisser un commentaire
Vous devez vous connecter pour publier un commentaire.